Des informations dispersées
PMS, plannings et comptes rendus de service donnent chacun une partie de la situation.
HOPR by RoomChecking — Directeurs d’exploitation
HOPR by RoomChecking relie chaque tâche, incident, contrôle et coût à une chronologie exploitable. La direction voit les priorités, les blocages et les récurrences sans attendre la consolidation de fichiers séparés.
La direction d’exploitation doit arbitrer en permanence entre niveau de service, disponibilité des équipes, urgence technique et maîtrise des coûts. Pourtant, une grande partie de l’information reste dispersée entre le PMS, les messageries, les feuilles de planning et les comptes rendus de service. HOPR transforme les actions quotidiennes en données structurées : création, attribution, durée, statut, preuve, commentaire, réassignation et résolution. Le pilotage devient une conséquence naturelle de l’exécution, et non un travail administratif supplémentaire.
PMS, plannings et comptes rendus de service donnent chacun une partie de la situation.
Arrivées prioritaires, charge disponible et urgences techniques demandent une décision commune.
Sans historique partagé, il est difficile de distinguer un incident isolé d’un problème de fond.
Voir les chambres ou espaces bloqués, les tâches en retard, les SLA à risque et les actions critiques.
Retrouver qui a créé, attribué, commencé, commenté ou clôturé une action et avec quelles preuves.
Composer des vues par service, zone ou période pour préparer les revues opérationnelles avec les informations utiles.
Relier les scores, écarts et corrections au même cycle d’amélioration.
Rattacher temps, matériaux et consommables pour éclairer les arbitrages opérationnels.
Suivez les actions, les responsabilités et les informations partagées à chaque étape.
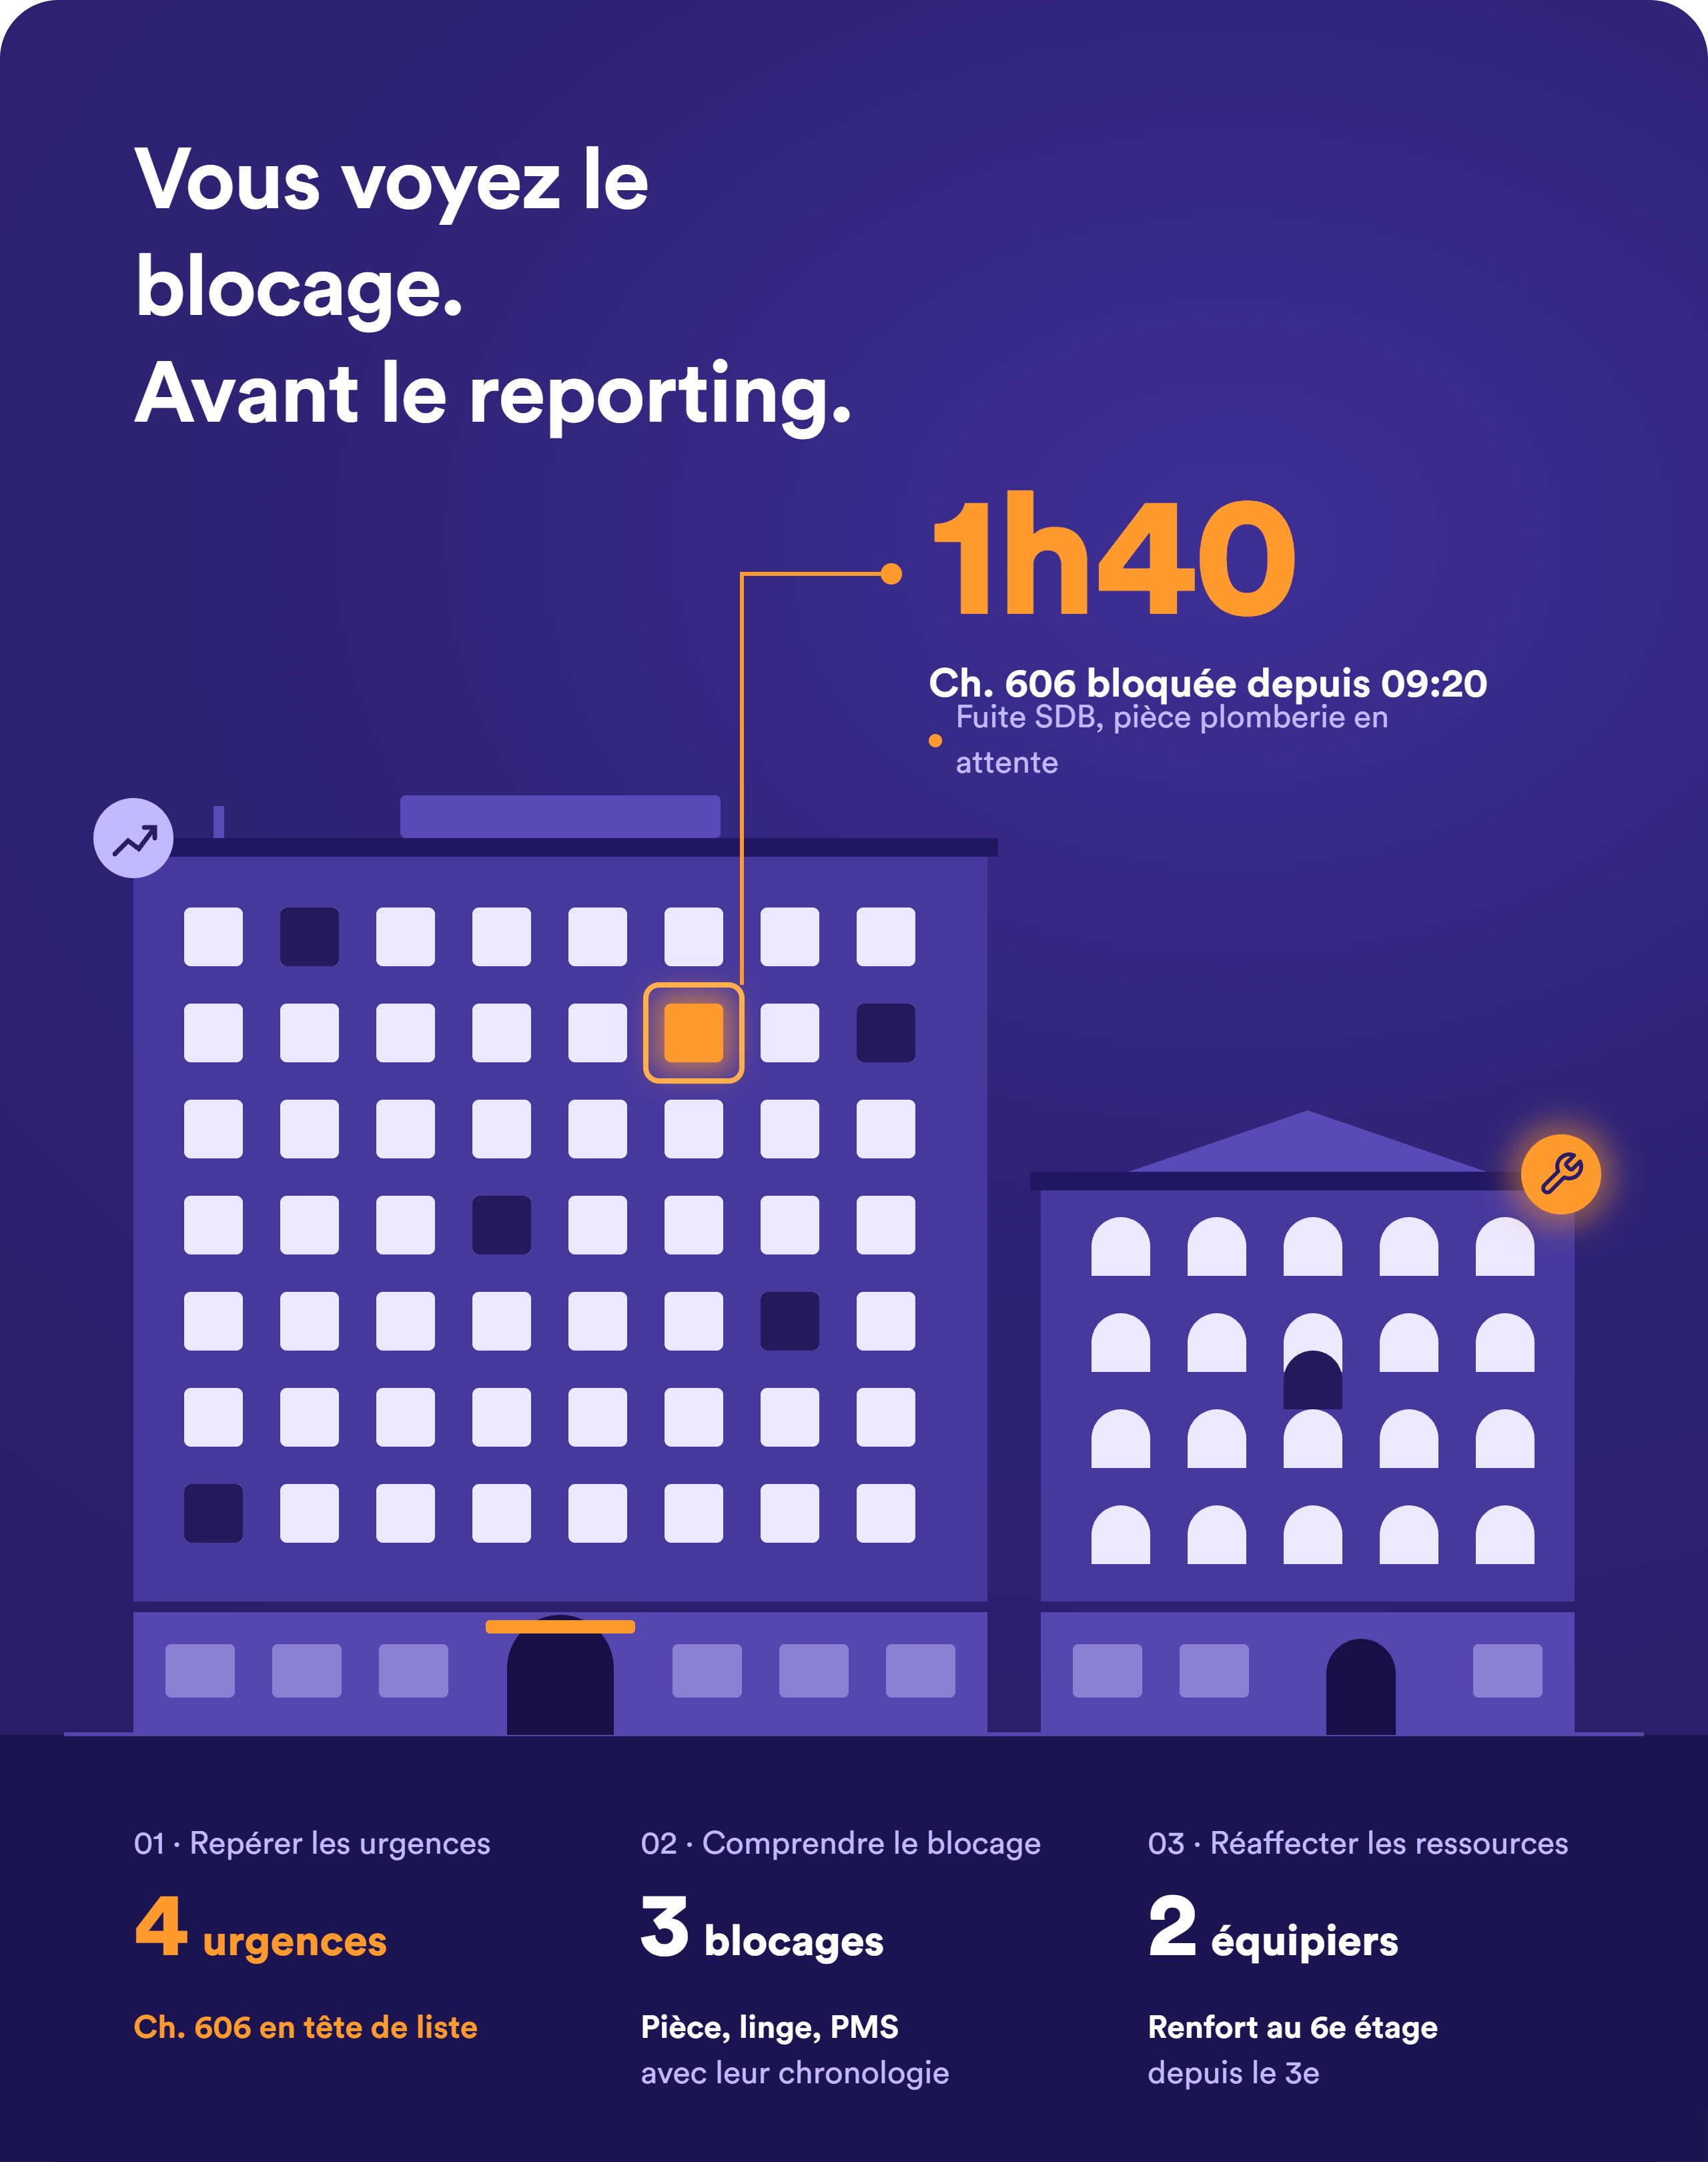
Le cockpit fait remonter les arrivées prioritaires, chambres bloquées et tâches proches de leur échéance de service.
La direction identifie qu’un incident maintenance empêche plusieurs inspections de se terminer.
Les ressources sont réaffectées sans perdre le contexte ; le front office voit immédiatement les nouveaux statuts.
Les écarts critiques sont suivis jusqu’à résolution avec photo et commentaire.
En fin de journée, la direction consulte les délais, récurrences et coûts sans demander un nouveau reporting aux managers.
Arbitrer plus tôt avec une information partagée.
Réduire les relances entre managers.
Relier qualité de service, charge et coûts.
Distinguer un incident isolé d’un problème récurrent.
Préparer les revues opérationnelles à partir de données traçables.
Le cockpit se concentre sur les décisions utiles : retards, blocages, priorités et coûts. Le déploiement définit les indicateurs, seuils d’alerte, périmètres de données et destinataires, avec un accès au détail de chaque action pour expliquer les résultats.
Tâches, statuts, délais, réassignations, preuves, audits et coûts alimentent les vues selon votre paramétrage et vos intégrations.
Les filtres permettent de lire l’activité par établissement, bâtiment, équipe, catégorie et période. Vous pouvez ainsi comparer les situations sur un périmètre précis.
Le cockpit se construit autour des exceptions : retards, délais de service à risque, blocages, récurrences et coûts inhabituels. Chaque vue doit faciliter une décision.
Oui. L’historique opérationnel permet de comprendre ce qui explique un indicateur : responsable, changements de statut, commentaires et preuves.
Les priorités, échéances et règles d’escalade sont paramétrées pour faire remonter les situations qui exigent l’intervention d’un responsable.
Un incident transversal, sa réaffectation, une escalade et sa résolution, puis la lecture des délais et coûts dans le cockpit.